



Segmentation du marché mondial de la classification des données Web, par composante (solutions et services), méthodologie (classification basée sur le contenu, classification basée sur le contexte et classification basée sur l'utilisateur), secteur vertical (banque, services financiers et assurances (BFSI), santé et sciences de la vie, gouvernement et défense, éducation, télécommunications, médias et divertissement, et autres) - Tendances et prévisions du secteur jusqu'en 2032
Qu'est-ce que la classification des données Web Taille du marché et taux de croissance
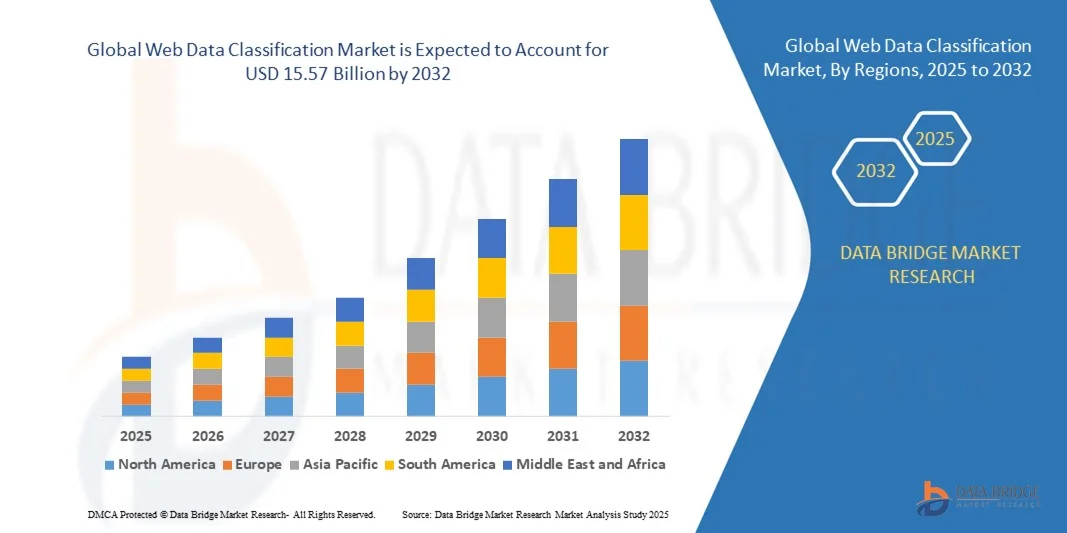
- La taille du marché mondial de la classification des données Web a été évaluée à2,58 milliards de dollars en 2024et devrait atteindre15,57 milliards de dollars en 2032, à unTCAC de 25,20 %pendant la période de prévision
- La croissance du marché est largement alimentée par l'adoption croissante de solutions fondées sur l'intelligence artificielle, l'apprentissage automatique et le cloud, ce qui permet aux organisations de catégoriser et de gérer efficacement de vastes volumes de données structurées et non structurées dans l'ensemble des industries.
- En outre, la demande croissante de solutions de classification des données sûres, exactes et automatisées incite les entreprises à adopter des plateformes de pointe qui garantissent la conformité à la réglementation, la protection des données et l'amélioration des capacités de décision. Ces facteurs accélèrent l'adoption de solutions de classification des données Web, ce qui stimule considérablement la croissance du marché.
Quelles sont les principales tendances du marché de la classification des données sur le Web
- La classification des données Web implique le processus de catégorisation des données en fonction du contenu, du contexte ou du comportement des utilisateurs pour améliorergouvernance des données, sécurité et accessibilité. Les solutions tirent parti de l'IA, de l'analyse sémantique et de l'apprentissage automatique pour rationaliser la gestion des données, réduire l'effort manuel et améliorer l'efficacité opérationnelle dans tous les secteurs
- L'augmentation de la demande de classification des données sur le Web est principalement attribuable à l'augmentation de la production de données numériques, à la réglementation rigoureuse en matière de protection des données et à la nécessité croissante pour les organisations de tirer des enseignements concrets de l'information non structurée, appuyant ainsi des décisions opérationnelles éclairées et la résilience opérationnelle.
- L'Amérique du Nord a dominé le marché de la classification des données Web avec une part de 33,3%en 2024, en raison de l'adoption croissante decalcul en nuage, l'analyse avancée et des réglementations strictes en matière de confidentialité des données telles que la CCPA
- L'Asie-Pacifique devrait être la région qui connaîtra la croissance la plus rapide sur le marché de la classification des données sur le Web au cours de la période de prévision en raison de l'augmentation de la numérisation, de l'expansion de l'infrastructure informatique et des télécommunications et de la sensibilisation croissante à la protection des données dans des pays comme la Chine, le Japon et l'Inde.
- Le segment des solutions a dominé le marché avec une part de marché de 61,8 % en 2024, en raison du déploiement croissant d'outils de classification avancés basés sur l'intelligence artificielle et l'apprentissage automatique qui aident les organisations à organiser et gérer efficacement des volumes massifs de données non structurées et structurées. Les solutions offrent des capacités de classification automatisées, évolutives et précises, permettant aux entreprises d'améliorer la gouvernance des données, la conformité et l'analyse. Les entreprises d'un secteur à l'autre privilégient les solutions pour leur capacité à s'intégrer parfaitement aux infrastructures informatiques et aux environnements cloud existants, ce qui réduit les efforts manuels et les coûts opérationnels. La demande croissante de données en temps réel et l'amélioration de la prise de décisions appuient également l'adoption de solutions globales
Taille du marché et prévisions
Valeur marchande mondiale (2024): USD
Valeur marchande prévue (2032) : USD
Prévisions CAGR (2025-2032):
Portée du rapport et classification des données sur le Web Segmentation du marché
|
Attributs |
Classification des données du Web Principales perspectives du marché |
|
Segments couverts |
|
|
Pays couverts |
Amérique du Nord
Europe
Asie-Pacifique
Moyen-Orient et Afrique
Amérique du Sud
|
|
Principaux acteurs du marché |
|
|
Possibilités de marché |
|
|
Infos sur la valeur ajoutée |
Outre les perspectives du marché telles que la valeur du marché, le taux de croissance, les segments de marché, la couverture géographique, les acteurs du marché et le scénario du marché, le rapport de marché préparé par l'équipe de recherche sur le marché de Data Bridge comprend une analyse approfondie des experts, une analyse des importations et des exportations, une analyse des prix, une analyse de la consommation de production et une analyse des ravageurs. |
Quelle est la tendance clé du marché de la classification des données Web
Utilisation accrue de l'IA pour la classification automatisée des données
- Le marché de la classification des données sur le Web se développe rapidement en raison de l'adoption croissante de technologies d'intelligence artificielle (IA) pour automatiser la catégorisation des données et les processus d'étiquetage. Les organisations qui s'occupent d'une grande quantité de données Web en ligne et d'entreprise tirent parti des algorithmes axés sur l'IA pour améliorer l'exactitude, réduire la charge de travail manuelle et accélérer la prise de décisions
- Par exemple, IBM et Microsoft Azure ont intégré des moteurs de classification basés sur la machine learning dans leurs plates-formes cloud, permettant d'étiqueter automatiquement les informations sensibles, les données client et le contenu propriétaire conformément aux règles de confidentialité. De même, AWS Macie utilise l'IA pour identifier et classifier les données personnelles dans les environnements de stockage en nuage, assurant ainsi une meilleure visibilité et un contrôle de conformité
- Les systèmes automatisés de classification alimentés par l'IA sont capables de traiter de grands ensembles de données en temps réel, en distinguant efficacement les données structurées, semi-structurées et non structurées. Ces solutions s'adaptent également à l'évolution des modèles de données, permettant une amélioration continue de la précision grâce à la formation des modèles et au renforcement de l'apprentissage.
- En outre, la classification fondée sur l'IA améliore l'efficacité opérationnelle dans des secteurs comme les finances, les soins de santé et la vente au détail en assurant une identification rapide des données essentielles pour l'analyse, les audits de conformité et les protocoles de sécurité. Les entreprises bénéficient d'une réduction de l'erreur humaine, de flux de travail optimisés et d'une meilleure gouvernance des données
- L'intégration du traitement du langage naturel (NLP) et des modèles d'apprentissage profond dans les outils de classification Web améliore la compréhension contextuelle, ce qui permet de catégoriser avec précision des ensembles de données complexes tels que les avis clients, les documents juridiques et le contenu multimédia. Cette tendance devrait s'accélérer à mesure que les entreprises développeront leurs initiatives de transformation numérique et exigeront des solutions évolutives et intelligentes de gestion des données.
- À mesure que les capacités d'intelligence artificielle évoluent, la classification automatisée des données deviendra une pierre angulaire de la gouvernance de l'information, favorisant un traitement plus rapide et plus sûr des données Web dans les industries mondiales. Cette tendance met en évidence le recours croissant à l'automatisation intelligente pour la gestion des actifs numériques à grande échelle dans les environnements réglementaires et analytiques
Dynamique du marché de la classification des données Web
Chauffeur
Accroître la conformité réglementaire et la sécurité des données
- Le renforcement des réglementations mondiales en matière de confidentialité et de sécurité des données est l'un des principaux moteurs du marché de la classification des données sur le Web. Les organisations doivent veiller au respect des cadres tels que le RGPD, le CCPA, le HIPAA et le SSD du PCI, qui exigent l'identification, le marquage et la protection exactes des informations sensibles stockées en ligne et dans les systèmes internes.
- Par exemple, Forcepoint et Symantec fournissent des solutions de classification qui aident les entreprises à détecter et à étiquetter des données commerciales confidentielles, des renseignements personnels et des détails de paiement pour respecter leurs obligations de conformité. Ces outils permettent l'application automatisée des politiques pour un traitement sûr des données tout en réduisant les risques d'infractions et les sanctions réglementaires
- La prévalence croissante des cybermenaces et des attaques contre les ransomwares a accru la nécessité d'une classification précise des données du Web pour mettre en place des contrôles d'accès efficaces et des mesures de chiffrement. En identifiant des informations sensibles et de grande valeur au début du cycle de vie des données, les entreprises peuvent renforcer les postures de sécurité et améliorer la réponse aux incidents
- De plus, les audits de conformité exigent de plus en plus de preuves de mesures de gouvernance des données. Les systèmes de classification des données sur le Web fournissent une traçabilité documentée et des rapports prêts à être vérifiés, ce qui permet aux organisations de mieux se conformer aux normes juridiques et industrielles.
- Alors que les organisations sont aux prises avec une augmentation du volume de données et un examen de plus en plus attentif des pratiques numériques, l'intégration des outils de classification dans les flux de travail de l'entreprise devient une étape essentielle pour préserver l'intégrité des entreprises et répondre aux exigences de conformité en évolution dans le monde entier
Restriction/Défi
Gestion de la croissance rapide des données non structurées
- L'un des défis les plus importants du marché de la classification des données Web est de gérer la croissance exponentielle des données non structurées, comme les courriels, les fichiers multimédias, le contenu des médias sociaux et les communications avec les clients. Les ensembles de données non structurés manquent souvent de formatage cohérent, ce qui les rend plus difficiles à analyser et à classer avec précision.
- Par exemple, des entreprises telles qu'OpenText et Informatica sont constamment confrontées à des difficultés dans la classification des archives non structurées à grande échelle tout en assurant la précision entre les langues, les formats et l'évolution continue des structures de contenu. La nature dynamique des données basées sur le texte, la vidéo et l'image nécessite des modèles analytiques avancés et des améliorations continues du modèle pour une classification efficace
- Le volume écrasant de données Web non structurées peut également imposer des ressources informatiques, ce qui entraîne des coûts de traitement plus élevés et des temps de classification plus longs. Les entreprises ont souvent besoin d'investissements importants dans l'infrastructure de l'IA, le stockage en nuage et la puissance de calcul évolutive pour gérer efficacement ces charges de travail.
- De plus, une classification inexacte des données non structurées peut conduire à une mauvaise gestion de l'information sensible, à des risques de conformité et à une détérioration des protocoles de sécurité. Assurer la précision de l'étiquetage nécessite des ensembles de données de formation de haute qualité, qui peuvent être coûteux et à long terme à développer
- Bien que les progrès en matière d'IA, de NLP et d'apprentissage approfondi améliorent les capacités, la nature imprévisible et la diversité des données non structurées demeurent des obstacles persistants. Pour surmonter ces défis, il faudra des innovations dans les modèles de classification adaptative, les cadres hybrides de gouvernance des données et les outils de traitement en temps réel pour maintenir l'exactitude tout en traitant des volumes de données en expansion rapide
Comment le marché de la classification des données Web est-il segmenté
Le marché est segmenté en fonction des composantes, de la méthodologie et de la verticale.
- Par composante
Sur la base de la composante, le marché de la classification des données sur le Web est segmenté en solutions et services. Le segment des solutions a dominé la plus grande part du marché de 61,8 % en 2024, grâce au déploiement croissant d'outils de classification avancés basés sur l'intelligence artificielle et l'apprentissage automatique qui aident les organisations à organiser et gérer efficacement des volumes massifs de données non structurées et structurées. Les solutions offrent des capacités de classification automatisées, évolutives et précises, permettant aux entreprises d'améliorer la gouvernance des données, la conformité et l'analyse. Les entreprises d'un secteur à l'autre privilégient les solutions pour leur capacité à s'intégrer parfaitement aux infrastructures informatiques et aux environnements cloud existants, ce qui réduit les efforts manuels et les coûts opérationnels. La demande croissante de données en temps réel et le renforcement de la prise de décisions appuient également l'adoption de solutions globales.
Le secteur des services devrait connaître le taux de croissance le plus rapide entre 2025 et 2032, alimenté par le recours croissant à des services de consultation, de mise en oeuvre et de gestion professionnels pour les projets de classification des données. Les services offrent des solutions personnalisées adaptées à un environnement de données spécifique de l'organisation, assurant une plus grande précision et conformité aux normes de l'industrie. Les entreprises qui manquent de compétences internes préfèrent les services de déploiement, de suivi et d'optimisation continue des cadres de classification. De plus, les services gérés et les offres par abonnement permettent aux petites et moyennes entreprises d'adopter des capacités de classification avancées.
- Par méthodologie
Sur la base de la méthodologie, le marché de la classification des données sur le Web est segmenté en classification fondée sur le contenu, classification fondée sur le contexte et classification fondée sur l'utilisateur. Le segment de la classification fondée sur le contenu détenait la plus grande part de revenus du marché en 2024, en raison de sa capacité à analyser les propriétés intrinsèques des données, y compris les mots-clés, les métadonnées et les structures de documents, afin de catégoriser et d'étiqueter le contenu avec précision. Cette méthodologie est largement préférée par les entreprises qui recherchent des solutions de classification automatisées et évolutives qui réduisent au minimum l'intervention humaine tout en assurant le respect des normes réglementaires. Son efficacité dans les grands ensembles de données des secteurs de la BFSI, des soins de santé et de l'État sous-tend sa position dominante sur le marché.
On s'attend à ce que le segment de la classification fondée sur le contexte soit témoin du TCAC le plus rapide de 2025 à 2032, alimenté par la demande croissante de systèmes de classification intelligents qui tiennent compte du contexte, des relations et de la signification sémantique des données. Les approches contextuelles permettent aux organisations d'approfondir leurs connaissances, d'améliorer leur personnalisation et de détecter plus efficacement les anomalies. Les entreprises qui traitent des ensembles de données complexes, comme les transactions financières ou les dossiers des patients, adoptent de plus en plus de méthodes contextuelles pour améliorer l'exactitude, réduire les erreurs et optimiser les flux de travail opérationnels.
- Par verticale
Sur la base de la verticale, le marché de la classification des données web est segmenté en BFSI, soins de santé et sciences de la vie, gouvernement et défense, éducation, télécommunications, médias et divertissement, et autres. La verticale de la BFSI a dominé la plus grande part des revenus du marché en 2024, en raison de la nécessité essentielle d'un traitement sûr, conforme et efficace des données financières sensibles. Les banques, les compagnies d'assurance et les sociétés d'investissement tirent de plus en plus parti des systèmes automatisés de classification pour rationaliser l'évaluation des risques, la conformité à la réglementation, la détection des fraudes et l'analyse des clients. Le volume élevé de données transactionnelles et générées par le client renforce encore la demande de solutions avancées dans ce secteur.
La verticale des soins de santé et des sciences de la vie devrait connaître le taux de croissance le plus rapide de 2025 à 2032, alimenté par la numérisation croissante des dossiers médicaux, des données de recherche et de l'information sur les essais cliniques. Les organismes de santé adoptent la classification des données sur le Web pour améliorer la gestion des données sur les patients, accélérer la recherche et assurer le respect des règlements tels que l'HIPAA et le RGPD. Les méthodes de classification avancées aident à l'organisation de dossiers médicaux non structurés, facilitant les idées en temps réel, l'analyse prédictive et les soins personnalisés aux patients. L'adoption croissante de technologies d'IA et d'apprentissage automatique dans les hôpitaux, les laboratoires et les sociétés pharmaceutiques accélère encore la croissance de cette verticale.
Quelle région détient la plus grande part du marché de la classification des données Web
- L'Amérique du Nord a dominé le marché de la classification des données sur le Web avec la plus grande part des revenus de 33,3 % en 2024, sous l'effet de l'adoption croissante de l'informatique en nuage, de l'analyse avancée et de la réglementation rigoureuse en matière de confidentialité des données, comme l'ACCP.
- Les entreprises de la région accordent la priorité à la gouvernance et au respect des données pour répondre aux préoccupations croissantes concernant les cybermenaces et l ' utilisation abusive de l ' information
- La forte présence des principaux fournisseurs de technologies, l'adoption rapide d'outils de classification des données fondées sur l'intelligence artificielle et des investissements importants dans l'infrastructure de sécurité des données renforcent encore la domination régionale
Classification des données sur le Web aux États-Unis
Le marché américain de la classification des données sur le Web a enregistré la plus grande part des revenus en 2024 en Amérique du Nord, grâce à la mise en oeuvre rapide d'initiatives de transformation numérique et à l'accent accru mis sur la conformité réglementaire. L'essor de la production de données non structurées, conjugué à l'expansion des déploiements de cloud dans les entreprises, stimule la croissance du marché. De plus, la présence de grandes entreprises technologiques et l'adoption croissante dans les secteurs de la BFSI, des soins de santé et de l'État continuent de stimuler l'expansion du marché.
Europe Classification des données sur le Web Aperçu du marché
Le marché européen de la classification des données sur le Web devrait s'étendre à un TCAC important tout au long de la période de prévision, principalement grâce à des réglementations strictes en matière de protection des données telles que le RGPD et à l'accent croissant mis sur la sécurisation des données des entreprises. La numérisation croissante entre les industries et la mise en oeuvre croissante de solutions automatisées de gestion des données favorisent l'adoption. Les organisations européennes mettent l'accent sur les systèmes de classification fondés sur l'IA pour rationaliser la conformité, accroître la transparence et atténuer les risques d'atteinte aux données.
Classification des données sur le Web au Royaume-Uni
Le marché britannique de la classification des données sur le Web devrait croître à un TCAC remarquable au cours de la période de prévision, en raison du resserrement des lois sur la protection des données et de l'utilisation croissante des technologies numériques dans les secteurs financier, public et des soins de santé. L'augmentation des investissements dans l'infrastructure de données, conjuguée à la demande croissante d'outils automatisés de traitement et de conformité, propulse la croissance du marché.
Allemagne Classification des données sur le Web Aperçu du marché
Le marché allemand de la classification des données sur le Web devrait se développer à un TCAC considérable pendant la période de prévision, alimenté par l'accent mis par le pays sur la cybersécurité, la conformité réglementaire et la numérisation industrielle. Les entreprises des secteurs manufacturier et public adoptent des plates-formes de classification basées sur l'IA pour gérer efficacement les volumes importants de données. L'Allemagne accorde une grande importance à la souveraineté des données et aux politiques informatiques axées sur l'innovation continuent de soutenir l'expansion régulière du marché.
Classification des données sur le Web en Asie et dans le Pacifique
Le marché de la classification des données sur le Web en Asie et dans le Pacifique est sur le point d'augmenter au rythme le plus rapide du TCAC de 2025 à 2032, en raison de l'augmentation de la numérisation, de l'expansion de l'infrastructure informatique et des télécommunications et de la sensibilisation à la protection des données dans des pays comme la Chine, le Japon et l'Inde. La croissance rapide du commerce électronique et des services cloud, ainsi que les initiatives gouvernementales visant à promouvoir la gouvernance numérique, accélèrent l'adoption. On s'attend à ce que le volume de données important de la région et les capacités émergentes en matière d'IA maintiennent une dynamique de croissance robuste.
Chine Classification des données sur le marché
En 2024, le marché chinois de la classification des données sur le Web représentait la plus grande part des revenus du marché en Asie-Pacifique, attribuable à la vigueur des mandats gouvernementaux en matière de sécurité des données et à l'adoption rapide dans les secteurs du commerce électronique, des finances et du secteur public. L'accent mis par la Chine sur la construction d'écosystèmes numériques sécurisés, appuyés par les fournisseurs nationaux d'IA et les progrès technologiques du cloud, continue de favoriser la croissance du marché.
Japan Web Data Classification Market Insight
Le marché japonais de la classification des données sur le Web prend de l'ampleur en raison des progrès technologiques du pays, des normes de conformité réglementaires élevées et de l'adoption croissante de l'IA et de l'analyse des mégadonnées. L'augmentation des initiatives de transformation numérique dans les secteurs des soins de santé, de la BFSI et du gouvernement, combinée à la demande de gestion des données sûre et efficace, alimente une croissance constante du marché.
Quelles sont les principales entreprises du marché de la classification des données sur le Web
L'industrie de la classification des données sur le Web est principalement dirigée par des entreprises bien établies, notamment :
- Société IBM(États-Unis)
- Google(États-Unis)
- Microsoft(États-Unis)
- Amazon Web Services, Inc. (États-Unis)
- Broadcom(États-Unis)
- Société en texte ouvert (Canada)
- BOLDON JAMES (Royaume-Uni)
- Varonis (États-Unis)
- Innovative Routines International (IRI), Inc. (États-Unis)
- MinerEye (Israël)
- PKWARE, Inc. (États-Unis)
- Informatica Corporation (États-Unis)
- Spirion, LLC (États-Unis)
- Clearswift GmbH (Allemagne)
- SECLORE (Inde)
- Titus (Canada)
- Netwrix Corporation (États-Unis)
- GTB Technologies, Inc. (États-Unis)
- Point de force (États-Unis)
- ConnectWise, LLC (États-Unis)
- SoftWorks AI (États-Unis)
- Janusnet Pty Limited (Australie)
Quels sont les derniers développements du marché mondial de la classification des données Web
- En octobre 2025, Clarivate a lancé son Classificateur d'Innography AI, offrant des capacités de classement des brevets avec une précision maximale de 97 %. Cette évolution met en lumière le fait que les systèmes de classification fondés sur l'intelligence artificielle sont de plus en plus utilisés pour automatiser la catégorisation des données à grande échelle et améliorer la précision dans la prise de décisions. En réduisant l'intervention manuelle et en améliorant l'efficacité de l'étalonnage, cette innovation renforce l'intégration de la classification intelligente des données dans les opérations stratégiques des entreprises
- En septembre 2025, Squirro, leader mondial des solutions d'IA et de graphe de connaissance de qualité d'entreprise, a annoncé la disponibilité générale de sa dernière mise à jour de plate-forme introduisant le classificateur Squirro. La mise à jour améliore la gestion des données par le biais d'une classification automatisée alignée sur les taxonomies organisationnelles, d'une détection avancée de l'IIP et d'un masquage du respect de la vie privée. Ces mises à niveau renforcent considérablement la précision des données, la sécurité et l'intelligence contextuelle, ce qui permet aux organisations de dégager des informations plus approfondies à partir de données non structurées.
- En juin 2025, Zscaler a dévoilé de nouvelles caractéristiques de classification des données à moteur d'IA conçues pour identifier et catégoriser plus de 200 types de données sensibles avec une précision comparable à celle de l'homme. Cette avancée souligne l'intégration accélérée de l'intelligence artificielle dans les cadres de sécurité des données, en améliorant l'analyse contextuelle et l'efficacité de la classification en temps réel. L'expansion de la fonctionnalité marque une étape importante vers la capacité des entreprises à gérer des volumes massifs d'informations sensibles de manière sûre et intelligente
- En juin 2025, Progress a publié une mise à jour avancée de sa plateforme Semaphore, intégrant des capacités d'IA sémantique qui automatisent l'extraction et la classification des données structurées et non structurées. Cette publication démontre la convergence constante entre la gestion des connaissances et la gouvernance des données, ce qui permet aux entreprises de gérer, d'interpréter et de protéger plus efficacement les actifs de données. L'intégration du renseignement sémantique facilite l'amélioration de la conformité, de la transparence opérationnelle et de la production de renseignements
- En août 2024, Varonis a introduit sa solution de découverte et de classification des données à moteur d'IA, améliorant la capacité des entreprises à détecter, surveiller et classer les informations sensibles dans plusieurs environnements de stockage. Cette évolution reflète la demande croissante d'automatisation intelligente pour identifier les données à haut risque et appliquer les protocoles de protection. En renforçant la visibilité et le contrôle des données d'entreprise, la solution contribue à améliorer la conformité réglementaire et la sécurité dans l'ensemble des industries
SKU-
Accédez en ligne au rapport sur le premier cloud mondial de veille économique

- Tableau de bord d'analyse de données interactif
- Tableau de bord d'analyse d'entreprise pour les opportunités à fort potentiel de croissance
- Accès d'analyste de recherche pour la personnalisation et les requêtes
- Analyse de la concurrence avec tableau de bord interactif
- Dernières actualités, mises à jour et analyse des tendances
- Exploitez la puissance de l'analyse comparative pour un suivi complet de la concurrence
Méthodologie de recherche
La collecte de données et l'analyse de l'année de base sont effectuées à l'aide de modules de collecte de données avec des échantillons de grande taille. L'étape consiste à obtenir des informations sur le marché ou des données connexes via diverses sources et stratégies. Elle comprend l'examen et la planification à l'avance de toutes les données acquises dans le passé. Elle englobe également l'examen des incohérences d'informations observées dans différentes sources d'informations. Les données de marché sont analysées et estimées à l'aide de modèles statistiques et cohérents de marché. De plus, l'analyse des parts de marché et l'analyse des tendances clés sont les principaux facteurs de succès du rapport de marché. Pour en savoir plus, veuillez demander un appel d'analyste ou déposer votre demande.
La méthodologie de recherche clé utilisée par l'équipe de recherche DBMR est la triangulation des données qui implique l'exploration de données, l'analyse de l'impact des variables de données sur le marché et la validation primaire (expert du secteur). Les modèles de données incluent la grille de positionnement des fournisseurs, l'analyse de la chronologie du marché, l'aperçu et le guide du marché, la grille de positionnement des entreprises, l'analyse des brevets, l'analyse des prix, l'analyse des parts de marché des entreprises, les normes de mesure, l'analyse globale par rapport à l'analyse régionale et des parts des fournisseurs. Pour en savoir plus sur la méthodologie de recherche, envoyez une demande pour parler à nos experts du secteur.
Personnalisation disponible
Data Bridge Market Research est un leader de la recherche formative avancée. Nous sommes fiers de fournir à nos clients existants et nouveaux des données et des analyses qui correspondent à leurs objectifs. Le rapport peut être personnalisé pour inclure une analyse des tendances des prix des marques cibles, une compréhension du marché pour d'autres pays (demandez la liste des pays), des données sur les résultats des essais cliniques, une revue de la littérature, une analyse du marché des produits remis à neuf et de la base de produits. L'analyse du marché des concurrents cibles peut être analysée à partir d'une analyse basée sur la technologie jusqu'à des stratégies de portefeuille de marché. Nous pouvons ajouter autant de concurrents que vous le souhaitez, dans le format et le style de données que vous recherchez. Notre équipe d'analystes peut également vous fournir des données sous forme de fichiers Excel bruts, de tableaux croisés dynamiques (Fact book) ou peut vous aider à créer des présentations à partir des ensembles de données disponibles dans le rapport.











