



Globale Marktsegmentierung für Webdatenklassifizierung nach Komponenten (Lösungen und Dienste), Methodik (inhaltsbasierte Klassifizierung, kontextbasierte Klassifizierung und benutzerbasierte Klassifizierung), vertikal (Banken, Finanzdienstleistungen und Versicherungen (BFSI), Gesundheitswesen und Biowissenschaften, Regierung und Verteidigung, Bildung, Telekommunikation, Medien und Unterhaltung und andere) – Branchentrends und Prognose bis 2032
Was ist die Web Data Klassifikation Markt Größe und Wachstum Rate
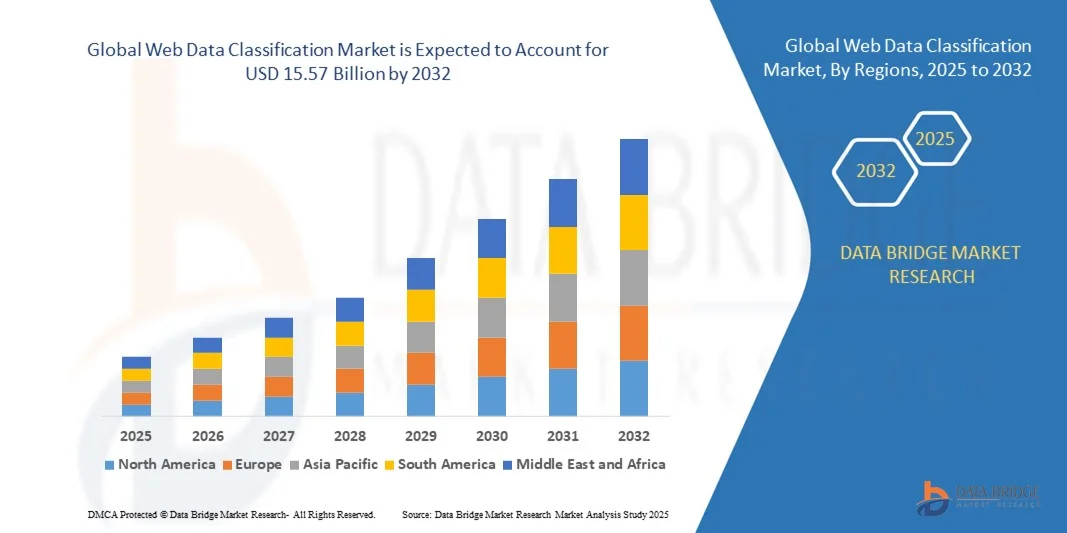
- Die globale Marktgröße für Webdatenklassifikation wurde mit2,58 Mrd. USD im Jahr 2024und wird voraussichtlich erreichen15,57 Milliarden USD bis 2032, beiCAGR von 25,20%während des Prognosezeitraums
- Das Marktwachstum wird größtenteils durch die zunehmende Übernahme von KI-, Machine Learning- und Cloud-basierten Lösungen gefördert, die es Unternehmen ermöglichen, umfassende Daten aus strukturierten und unstrukturierten Daten in den Branchen effizient zu kategorisieren und zu verwalten.
- Darüber hinaus treibt die steigende Nachfrage nach sicheren, präzisen und automatisierten Datenklassifizierungslösungen Unternehmen an, fortschrittliche Plattformen zu übernehmen, die die Einhaltung der Vorschriften, die Privatsphäre der Daten und die Verbesserung der Entscheidungsfähigkeit gewährleisten. Diese Faktoren beschleunigen die Aufnahme von Web-Datenklassifikationslösungen, was das Marktwachstum deutlich steigert
Was sind die großen Takeaways des Web Data Classification Market
- Web-Datenklassifikation beinhaltet den Prozess der Kategorisierung von Daten basierend auf Inhalt, Kontext oder Benutzerverhalten, um zu verbessernDatenverwaltungSicherheit und Zugänglichkeit. Lösungen nutzen KI, semantische Analyse und maschinelles Lernen, um das Datenmanagement zu optimieren, den manuellen Aufwand zu reduzieren und die betriebliche Effizienz in allen Sektoren zu steigern
- Die zunehmende Nachfrage nach Web-Datenklassifikation wird in erster Linie durch den Anstieg der digitalen Datengenerierung, strenge Datenschutzbestimmungen und den wachsenden Bedarf an Organisationen zur Ableitung von handlungsfähigen Erkenntnissen aus unstrukturierten Informationen, wodurch fundierte Geschäftsentscheidungen und operative Widerstandsfähigkeit unterstützt werden
- Nordamerika dominierte den Web-Datenklassifikationsmarkt mit einem Anteil von 33,3%2024, aufgrund der wachsenden AnnahmeCloud Computing, fortschrittliche Analysen und strenge Datenschutzbestimmungen wie die CCPA
- Asia-Pacific wird voraussichtlich die am schnellsten wachsende Region im Web-Datenklassifikationsmarkt während der Prognosezeit sein, da die Digitalisierung, die Erweiterung der IT- und Telekommunikationsinfrastruktur und das zunehmende Bewusstsein für den Datenschutz in Ländern wie China, Japan und Indien
- Das Segment Solutions dominierte den Markt mit einem Marktanteil von 61,8% im Jahr 2024, aufgrund des zunehmenden Einsatzes fortschrittlicher Klassifikations- und maschineller Klassifikationstools, die Unternehmen dabei unterstützen, massenhafte Mengen unstrukturierter und strukturierter Daten effizient zu organisieren und zu verwalten. Lösungen bieten automatisierte, skalierbare und präzise Klassifikationsfunktionen, sodass Unternehmen die Datenverwaltung, Compliance und Analytik verbessern können. Unternehmen in allen Branchen priorisieren Lösungen für ihre nahtlose Integration in bestehende IT-Infrastrukturen und Cloud-Umgebungen, wodurch manuelle Anstrengung und Betriebskosten reduziert werden. Die wachsende Nachfrage nach Echtzeit-Dateneinsichten und eine verbesserte Entscheidungsfindung unterstützt auch die Einführung umfassender Lösungen
Marktgröße und Prognose
Globaler Marktwert (2024): USD
Voraussichtlicher Marktwert (2032): USD
Prognose CAGR (2025–2032):
Report Scope und Web Data Classification Market Segmentation
|
Attribute |
Web Data Klassifikation Schlüsselmarkt Insights |
|
Verdeckte Segmente |
|
|
Überarbeitete Länder |
Nordamerika
Europa
Asien-Pazifik
Naher Osten und Afrika
Südamerika
|
|
Key Market Players |
|
|
Marktmöglichkeiten |
|
|
Daten Infos zum Wert hinzugefügt |
Neben den Markteinblicken wie Marktwert, Wachstumsrate, Marktsegmente, geographischer Erfassung, Marktteilnehmer und Marktszenario umfasst der vom Data Bridge Market Research Team kuratierte Marktbericht eine tiefgreifende Expertenanalyse, Import/Export-Analyse, Preisanalyse, Produktionsverbrauchsanalyse und pestle-Analyse. |
Was ist der Haupttrend im Web Data Classification Market
Nutzung von KI zur automatisierten Datenklassifizierung
- Der Web-Datenklassifizierungsmarkt wächst aufgrund der zunehmenden Übernahme künstlicher Intelligenz (KI) Technologien zur Automatisierung von Datenkategorisierung und -markierungsprozessen rasch. Organisationen, die sich mit riesigen Mengen von Online- und Unternehmenswebdaten beschäftigen, nutzen AI-getriebene Algorithmen, um die Genauigkeit zu verbessern, manuelle Arbeitsbelastungen zu reduzieren und die Entscheidungsfindung zu beschleunigen
- So haben IBM und Microsoft Azure maschinenlernbasierte Klassifikations-Engines in ihre Cloud-Plattformen integriert und ermöglichen eine automatisierte Kennzeichnung sensibler Informationen, Kundendaten und proprietärer Inhalte in Übereinstimmung mit den Datenschutzbestimmungen. Ebenso nutzt AWS Macie AI, um personenbezogene Daten innerhalb von Cloud-Speicherumgebungen zu identifizieren und zu klassifizieren, um eine verbesserte Sichtbarkeit und Compliance-Kontrolle zu gewährleisten
- Automatisierte Klassifikationssysteme, die von AI betrieben werden, sind in der Lage, große Datensätze in Echtzeit zu verarbeiten, zwischen strukturierten, halbstrukturierten und unstrukturierten Daten effizient zu unterscheiden. Diese Lösungen passen sich auch an sich entwickelnde Datenmodelle an, die eine kontinuierliche Verbesserung der Genauigkeit durch Modellschulung und Verstärkungslernen ermöglichen
- Darüber hinaus verbessert die Klassifikation mit AI die operative Effizienz in Industrien wie Finanzen, Gesundheitswesen und Einzelhandel, indem eine schnelle Identifizierung kritischer Daten für Analytik, Compliance Audits und Sicherheitsprotokolle gewährleistet wird. Unternehmen profitieren von reduzierten menschlichen Fehlern, optimierten Workflows und verbesserter Datenverwaltung
- Die Integration der natürlichen Sprachverarbeitung (NLP) und der tiefen Lernmodelle in Webklassifikationstools verbessert das kontextuelle Verständnis und ermöglicht die genaue Kategorisierung komplexer Datensätze wie Kundenrezensionen, Rechtsdokumente und Multimedia-Inhalte. Dieser Trend wird sich beschleunigen, da Unternehmen digitale Transformationsinitiativen erweitern und skalierbare, intelligente Datenmanagementlösungen benötigen
- Da sich die KI-Fähigkeiten entwickeln, wird die automatisierte Datenklassifizierung zu einem Eckpfeiler der Informations-Governance werden und eine schnellere und sicherere Verarbeitung von Webdaten in globalen Branchen unterstützen. Dieser Trend unterstreicht die wachsende Abhängigkeit von intelligenter Automatisierung für das groß angelegte digitale Asset Management in regulatorischen und analytischen Umgebungen
Web Data Klassifikation Marktdynamik
Fahrer
Erhöhung der regulatorischen Compliance und der sicheren Datenanforderungen
- Die Einhaltung globaler Vorschriften über Datenschutz und Sicherheit sind ein primärer Treiber des Web-Datenklassifikationsmarktes. Organisationen müssen die Einhaltung von Rahmenbedingungen wie DSGVO, CCPA, HIPAA und PCI DSS sicherstellen, die eine genaue Identifizierung, Kennzeichnung und Schutz sensibler online gespeicherter Informationen und innerhalb interner Systeme erfordern
- So bieten Forcepoint und Symantec Klassifikationslösungen, die Unternehmen dabei unterstützen, vertrauliche Geschäftsdaten, personenbezogene Daten und Zahlungsdaten zu erkennen und zu etikettieren, um Compliance-Verpflichtungen zu erfüllen. Diese Tools ermöglichen eine automatisierte politische Durchsetzung für eine sichere Datenverarbeitung und reduzieren gleichzeitig das Risiko von Verstößen und regulatorischen Sanktionen
- Die zunehmende Prävalenz von Cyber-Bedrohungen und Ransomware-Angriffen hat die Notwendigkeit einer präzisen Klassifizierung von Webdaten erhöht, um effektive Zugriffskontrollen und Verschlüsselungsmaßnahmen zu implementieren. Durch die frühzeitige Identifizierung sensibler und hochwertiger Informationen im Daten-Lebenszyklus können die Unternehmen die Sicherheitshaltung stärken und die Vorfallsantwort verbessern
- Darüber hinaus erfordern Compliance-Audits zunehmend einen Nachweis von Maßnahmen zur Datenverwaltung. Web-Datenklassifikationssysteme bieten dokumentierte Rückverfolgbarkeit und prüfungsbereite Berichterstattung, so dass Unternehmen die Einhaltung gesetzlicher und branchenspezifischer Standards leichter nachweisen können
- Da Organisationen mit steigenden Datenmengen und zunehmender Kontrolle digitaler Praktiken umgehen, wird die Integration von Klassifikationstools in Unternehmensabläufe zu einem wesentlichen Schritt bei der Sicherung der Unternehmensintegrität und der Erfüllung von Compliance-Anforderungen weltweit
Zurückhaltung/Challenge
Schnelles Wachstum von unstrukturierten Daten
- Eine der wichtigsten Herausforderungen im Web-Datenklassifizierungsmarkt ist das exponentielle Wachstum unstrukturierter Daten wie E-Mails, Multimedia-Dateien, Social Media-Inhalte und Kundenkommunikation. Unstrukturierte Datensätze fehlen oft nicht durchgängige Formatierung, wodurch sie schwieriger zu analysieren und genau zu klassifizieren
- So stehen Unternehmen wie OpenText und Informatica vor ständigen Komplexitäten in der Klassifizierung von großformatigen unstrukturierten Archiven und gewährleisten gleichzeitig die Genauigkeit in Sprachen, Formaten und sich ständig verändernden Inhaltsstrukturen. Die Dynamik von Text-, Video- und Bilddaten erfordert fortschrittliche Analysemodelle und kontinuierliche Modellveredelung für eine effektive Klassifizierung
- Das überwältigende Volumen von unstrukturierten Webdaten kann auch Rechenressourcen spannen, was zu höheren Verarbeitungskosten und längeren Klassifikationszeiten führt. Unternehmen benötigen oft erhebliche Investitionen in KI-Infrastruktur, Cloud-Speicher und skalierbare Rechenleistung, um solche Workloads effizient zu verwalten
- Darüber hinaus kann eine ungenaue Klassifizierung unstrukturierter Daten zu einer Fehlverwaltung sensibler Informationen führen, die Compliance-Risiken aussetzen und Sicherheitsprotokolle untergraben. Die Sicherstellung der Präzision bei der Etikettierung erfordert qualitativ hochwertige Trainingsdatensätze, die kostspielig und zeitintensiv zu entwickeln sind
- Obwohl Fortschritte bei KI, NLP und Deep Learning die Fähigkeiten verbessern, bleiben die unvorhersehbare Natur und die Vielfalt unstrukturierter Daten dauerhafte Hindernisse. Die Bewältigung dieser Herausforderungen erfordert Innovationen in adaptiven Klassifikationsmodellen, Hybrid-Daten-Governance-Frameworks und Echtzeit-Verarbeitungstools, um die Genauigkeit bei der schnellen Erweiterung der Datenvolumina zu erhalten.
Wie wird der Web Data Classification Market segmentiert
Der Markt wird auf der Grundlage von Komponente, Methodik und vertikal segmentiert.
- Von der Komponente
Auf Basis der Komponente wird der Webdatenklassifikationsmarkt in Lösungen und Dienstleistungen segmentiert. Das Segment der Lösungen dominierte den größten Marktanteil von 61,8% im Jahr 2024, angetrieben durch die zunehmende Bereitstellung von fortschrittlichen Klassifikationstools für KI- und maschinelles Lernen, die Unternehmen dabei unterstützen, massive Datenmengen unstrukturierter und strukturierter Daten effizient zu organisieren und zu verwalten. Lösungen bieten automatisierte, skalierbare und präzise Klassifikationsfunktionen, sodass Unternehmen die Datenverwaltung, Compliance und Analytik verbessern können. Unternehmen in allen Branchen priorisieren Lösungen für ihre nahtlose Integration in bestehende IT-Infrastrukturen und Cloud-Umgebungen, wodurch manuelle Anstrengung und Betriebskosten reduziert werden. Die wachsende Nachfrage nach Echtzeit-Dateneinsichten und eine verbesserte Entscheidungsfindung unterstützt auch die Einführung umfassender Lösungen.
Das Dienstleistungssegment wird voraussichtlich die schnellste Wachstumsrate von 2025 bis 2032 beobachten, die durch die zunehmende Abhängigkeit von professionellen Beratungs-, Implementierungs- und Managed Services für Datenklassifikationsprojekte gefördert wird. Dienstleistungen bieten maßgeschneiderte Lösungen, die auf das spezifische Datenumfeld einer Organisation zugeschnitten sind und eine höhere Genauigkeit und Einhaltung der Industriestandards gewährleisten. Unternehmen ohne hausinterne Expertise bevorzugen Dienstleistungen für die Bereitstellung, Überwachung und kontinuierliche Optimierung von Klassifikationsrahmen. Darüber hinaus machen die verwalteten Dienstleistungen und das Abonnement-basierte Angebot es kostengünstig für kleine und mittlere Unternehmen, erweiterte Klassifikationsfähigkeiten zu übernehmen.
- Nach Methodik
Auf der Grundlage der Methodik wird der Web-Datenklassifikationsmarkt in eine inhaltliche Klassifizierung, kontextbasierte Klassifikation und nutzerbasierte Klassifikation segmentiert. Das Content-basierte Klassifikationssegment hielt den größten Marktanteil im Jahr 2024, der durch seine Fähigkeit, die intrinsischen Eigenschaften von Daten zu analysieren, einschließlich Schlüsselwörtern, Metadaten und Dokumentstrukturen, um Inhalte genau zu kategorisieren und zu markieren. Diese Methode wird von Unternehmen, die automatisierte, skalierbare Klassifikationslösungen suchen, weit verbreitet, die die menschliche Intervention minimieren und gleichzeitig die Einhaltung regulatorischer Standards gewährleisten. Seine Effizienz in großen Datensätzen in BFSI-, Gesundheits- und Regierungsbereichen unterstreicht seine beherrschende Stellung im Markt.
Das kontextbasierte Klassifikationssegment wird erwartet, dass das schnellste CAGR von 2025 bis 2032 bezeugt wird, das durch die wachsende Nachfrage nach intelligenten Klassifikationssystemen, die den umgebenden Kontext, die Beziehungen und die semantische Bedeutung von Daten berücksichtigen, gefördert wird. Kontextbasierte Ansätze ermöglichen Organisationen, tiefere Einblicke abzuleiten, die Personalisierung zu verbessern und Anomalien effizienter zu erkennen. Unternehmen, die komplexe Datensätze wie Finanztransaktionen oder Patientenaufzeichnungen behandeln, nehmen zunehmend kontextbasierte Methoden an, um die Genauigkeit zu verbessern, Fehler zu reduzieren und operative Workflows zu optimieren.
- Von Vertical
Auf der Grundlage der vertikalen, wird der Web-Datenklassifikation Markt in BFSI, Gesundheits- und Life Sciences, Regierung und Verteidigung, Bildung, Telekommunikation, Medien und Unterhaltung, und andere segmentiert. Die BFSI vertikal dominierte den größten Marktanteil im Jahr 2024, der von der kritischen Notwendigkeit eines sicheren, konformen und effizienten Umgangs mit sensiblen Finanzdaten angetrieben wurde. Banken, Versicherungen und Investmentgesellschaften nutzen zunehmend automatisierte Klassifikationssysteme, um Risikobewertung, regulatorische Compliance, Betrugserkennung und Kundenanalyse zu optimieren. Das hohe Volumen an Transaktions- und Kundendaten stärkt die Nachfrage nach fortschrittlichen Lösungen in diesem Bereich weiter.
Die vertikale Gesundheits- und Lebenswissenschaften wird voraussichtlich die schnellste Wachstumsrate von 2025 bis 2032 beobachten, die durch die zunehmende Digitalisierung von medizinischen Aufzeichnungen, Forschungsdaten und klinischen Studieninformationen gefördert wird. Healthcare-Organisationen nehmen Webdatenklassifikation an, um das Patientendatenmanagement zu verbessern, die Forschung zu beschleunigen und die Einhaltung von Vorschriften wie HIPAA und DSGVO sicherzustellen. Fortgeschrittene Klassifizierungsmethoden helfen bei der Organisation von unstrukturierten medizinischen Aufzeichnungen, erleichtern Echtzeit-Einsichten, Vorhersageanalysen und personalisierte Patientenversorgung. Die zunehmende Übernahme von KI- und maschinellen Lerntechnologien in Krankenhäusern, Labors und Pharmaunternehmen beschleunigt das Wachstum in dieser Vertikalen weiter.
Welche Region hält den größten Teil des Web Data Classification Market
- Nordamerika dominierte den Web-Datenklassifikationsmarkt mit dem größten Umsatzanteil von 33,3 % im Jahr 2024, der von der wachsenden Annahme von Cloud Computing, fortschrittlicher Analytik und strengen Datenschutzbestimmungen wie der CCPA angetrieben wurde.
- Unternehmen in der Region priorisieren die Daten-Governance und die Einhaltung steigender Bedenken gegenüber Cyber-Bedrohungen und Informationsmissbrauch
- Die starke Präsenz von großen Technologieanbietern, die frühzeitige Übernahme von KI-basierten Datenklassifikationstools und hohe Investitionen in die Datensicherheitsinfrastruktur stärken die regionale Dominanz
U.S. Web Data Classification Market Insight
Der US-Webdatenklassifikationsmarkt erfasste den größten Umsatzanteil im Jahr 2024 in Nordamerika, der durch die rasche Umsetzung von digitalen Transformationsinitiativen und die zunehmende Betonung der regulatorischen Compliance vorangetrieben wurde. Der Anstieg der unstrukturierten Datengenerierung, verbunden mit der Erweiterung von Cloud-Einsätzen über Unternehmen, treibt das Marktwachstum voran. Darüber hinaus verstärkt die Präsenz von großen Technologieunternehmen und die zunehmende Übernahme in BFSI-, Gesundheits- und Regierungssektoren die Expansion des Marktes weiter.
Europa Web Data Classification Market Insight
Der europäische Web-Datenklassifikationsmarkt soll sich während der gesamten Prognosezeit bei einem wesentlichen CAGR ausweiten, vor allem durch strenge Datenschutzbestimmungen wie DSGVO und den steigenden Fokus auf die Sicherung von Unternehmensdaten. Die zunehmende Digitalisierung in allen Branchen und die zunehmende Implementierung automatisierter Datenmanagementlösungen fördern die Adoption. Die europäischen Organisationen betonen, dass Klassifikationssysteme mit AI-fähigen Systemen optimiert werden, um die Compliance zu optimieren, Transparenz zu verbessern und die Risiken von Datenverletzungen zu mindern.
U.K. Web Data Classification Market Insight
Der U.K.-Webdatenklassifikationsmarkt wird voraussichtlich während der Prognosezeit bei einem bemerkenswerten CAGR wachsen, der durch die Verschärfung der Datenschutzgesetze und den wachsenden Einsatz digitaler Technologien in den Bereichen Finanzen, Öffentlichkeit und Gesundheitswesen vorangetrieben wird. Die zunehmende Investition in die Dateninfrastruktur in der Region sowie die wachsende Nachfrage nach automatisierten Datenverarbeitungs- und Compliance-Tools treiben das Marktwachstum voran.
Deutschland Web Data Classification Market Insight
Der deutsche Web-Datenklassifikationsmarkt wird voraussichtlich während des Prognosezeitraums mit einem beträchtlichen CAGR expandieren, der durch den Schwerpunkt des Landes auf Cybersicherheit, Regulierungskonformität und industrielle Digitalisierung gefördert wird. Unternehmen im gesamten verarbeitenden Gewerbe und im öffentlichen Sektor übernehmen Klassifikationsplattformen, um große Datenmengen effizient zu verwalten. Der starke Fokus Deutschlands auf Datenhoheit und innovationsgetriebene IT-Politik unterstützt weiterhin eine stetige Markterweiterung.
Asia-Pacific Web Data Classification Market Insight
Der asiatisch-pazifische Web-Datenklassifikationsmarkt ist bereit, mit dem schnellsten CAGR von 2025 bis 2032 zu wachsen, angetrieben durch die zunehmende Digitalisierung, die Ausweitung der IT- und Telekommunikationsinfrastruktur und das wachsende Bewusstsein für den Datenschutz in Ländern wie China, Japan und Indien. Das rasante Wachstum in E-Commerce- und Cloud-Diensten sowie staatliche Initiativen zur Förderung der digitalen Governance beschleunigen die Adoption. Die großen Datenmengen und die aufstrebenden KI-Fähigkeiten der Region werden erwartet, dass sie eine solide Wachstumsdynamik erhalten.
China Web Data Classification Market Insight
Der China-Webdatenklassifikationsmarkt entfiel 2024 auf den größten Marktanteil im asiatisch-pazifischen Markt, der starken Regierungsdatensicherheitsmandate und einer raschen Übernahme im E-Commerce-, Finanz- und öffentlichen Sektor zuzuschreiben war. Chinas Schwerpunkt auf dem Aufbau sicherer digitaler Ökosysteme, unterstützt von inländischen KI-Anbietern und Cloud-Technologie-Fortschritten, treibt weiterhin das Marktwachstum voran.
Japan Web Data Classification Market Insight
Der Markt für Webdatenklassifizierung in Japan gewinnt an Dynamik aufgrund der technologischen Weiterentwicklung, der hohen Compliance-Standards und der zunehmenden Übernahme von KI- und Big Data Analytics. Der Anstieg der digitalen Transformationsinitiativen im Gesundheitswesen, im BFSI und im öffentlichen Sektor, verbunden mit der Forderung nach einem sicheren und effizienten Datenmanagement, treibt stetiges Marktwachstum voran.
Welche sind die Top-Unternehmen im Web Data Classification Market
Die Webdatenklassifikationsindustrie wird in erster Linie von etablierten Unternehmen geleitet, darunter:
- IBM Corporation(US)
- Google(US)
- Microsoft(US)
- Amazon Web Services, Inc(US)
- Broadcom(US)
- Open Text Corporation (Kanada)
- BOLDON JAMES (USA)
- Varonis (USA)
- Innovative Routines International (IRI), Inc. (USA)
- MinerEye (Insel)
- PKWARE, Inc. (USA)
- Informatica Corporation (USA)
- Spirion, LLC (USA)
- Clearswift GmbH (Deutschland)
- SECLORE (Indien)
- Titus (Kanada)
- Netwrix Corporation (USA)
- GTB Technologies, Inc. (USA)
- Forcepoint (USA)
- ConnectWise, LLC (USA)
- SoftWorks AI (USA)
- Janusnet Pty Limited (Australien)
Was sind die neuesten Entwicklungen im Global Web Data Classification Market
- Im Oktober 2025 startete Clarivate seinen Innography AI Classifier und bietet Patentklassifikationsfähigkeiten mit bis zu 97% Erstpassgenauigkeit. Diese Weiterentwicklung unterstreicht die zunehmende Abhängigkeit von KI-getriebenen Klassifikationssystemen, um eine groß angelegte Datenkategorisierung zu automatisieren und die Präzision bei der Unternehmensentscheidung zu verbessern. Durch die Verringerung der manuellen Intervention und die Verbesserung der Benchmarking-Effizienz stärkt diese Innovation die Integration einer intelligenten Datenklassifizierung in strategische Geschäftsfelder
- Im September 2025 kündigte Squirro, ein weltweit führender Anbieter von Lösungen für generative KI- und Wissensdiagramme, die allgemeine Verfügbarkeit seines neuesten Plattform-Updates mit dem Squirro Classifier an. Das Update verbessert die Unternehmensdatenverwaltung durch automatisierte Klassifikation im Einklang mit organisatorischen Taxonomien, erweiterter PII-Erkennung und Maskierung für die Einhaltung der Privatsphäre. Diese Upgrades verbessern die Datengenauigkeit, Sicherheit und kontextuelle Intelligenz deutlich und ermöglichen es Organisationen, tiefere Einblicke aus unstrukturierten Daten zu entsperren
- Im Juni 2025 enthüllte Zscaler neue KI-gestützte Datenklassifikationsmerkmale, mit denen über 200 sensible Datentypen mit humaner Präzision identifiziert und Kategorisiert werden sollen. Diese Weiterentwicklung unterstreicht die beschleunigte Integration von künstlicher Intelligenz in Rahmen der Datensicherheit, die Verbesserung der Kontextanalyse und der Echtzeit-Klassifikationseffizienz. Die Erweiterung der Funktion markiert einen wichtigen Schritt, um Unternehmen zu ermöglichen, massive Mengen sensibler Informationen sicher und intelligent zu handhaben
- Im Juni 2025 veröffentlichte Progress ein erweitertes Update auf seine Semaphore-Plattform mit semantischen KI-Fähigkeiten, die die Extraktion und Klassifizierung von strukturierten und unstrukturierten Daten automatisieren. Diese Veröffentlichung zeigt die anhaltende Konvergenz zwischen Wissensmanagement und Datenverwaltung, die es Unternehmen ermöglicht, Datenbestände effizienter zu verwalten, zu interpretieren und zu schützen. Die semantische Intelligenz-Integration erleichtert eine verbesserte Compliance, operative Transparenz und Einblicksgenerierung
- Im August 2024 stellte Varonis seine AI-powered Data Discovery and Classification Lösung vor, um die Fähigkeit der Unternehmen zu verbessern, sensible Informationen in mehreren Speicherumgebungen zu erkennen, zu überwachen und zu klassifizieren. Diese Entwicklung spiegelt die wachsende Nachfrage nach intelligenter Automatisierung bei der Identifizierung von Hochrisikodaten und der Durchsetzung von Schutzprotokollen wider. Durch die Stärkung der Sichtbarkeit und Kontrolle über Unternehmensdaten trägt die Lösung dazu bei, die Einhaltung und die Sicherheit der Unternehmen in allen Branchen zu verbessern
SKU-
Erhalten Sie Online-Zugriff auf den Bericht zur weltweit ersten Market Intelligence Cloud

- Interaktives Datenanalyse-Dashboard
- Unternehmensanalyse-Dashboard für Chancen mit hohem Wachstumspotenzial
- Zugriff für Research-Analysten für Anpassungen und Abfragen
- Konkurrenzanalyse mit interaktivem Dashboard
- Aktuelle Nachrichten, Updates und Trendanalyse
- Nutzen Sie die Leistungsfähigkeit der Benchmark-Analyse für eine umfassende Konkurrenzverfolgung
Forschungsmethodik
Die Datenerfassung und Basisjahresanalyse werden mithilfe von Datenerfassungsmodulen mit großen Stichprobengrößen durchgeführt. Die Phase umfasst das Erhalten von Marktinformationen oder verwandten Daten aus verschiedenen Quellen und Strategien. Sie umfasst die Prüfung und Planung aller aus der Vergangenheit im Voraus erfassten Daten. Sie umfasst auch die Prüfung von Informationsinkonsistenzen, die in verschiedenen Informationsquellen auftreten. Die Marktdaten werden mithilfe von marktstatistischen und kohärenten Modellen analysiert und geschätzt. Darüber hinaus sind Marktanteilsanalyse und Schlüsseltrendanalyse die wichtigsten Erfolgsfaktoren im Marktbericht. Um mehr zu erfahren, fordern Sie bitte einen Analystenanruf an oder geben Sie Ihre Anfrage ein.
Die wichtigste Forschungsmethodik, die vom DBMR-Forschungsteam verwendet wird, ist die Datentriangulation, die Data Mining, die Analyse der Auswirkungen von Datenvariablen auf den Markt und die primäre (Branchenexperten-)Validierung umfasst. Zu den Datenmodellen gehören ein Lieferantenpositionierungsraster, eine Marktzeitlinienanalyse, ein Marktüberblick und -leitfaden, ein Firmenpositionierungsraster, eine Patentanalyse, eine Preisanalyse, eine Firmenmarktanteilsanalyse, Messstandards, eine globale versus eine regionale und Lieferantenanteilsanalyse. Um mehr über die Forschungsmethodik zu erfahren, senden Sie eine Anfrage an unsere Branchenexperten.
Anpassung möglich
Data Bridge Market Research ist ein führendes Unternehmen in der fortgeschrittenen formativen Forschung. Wir sind stolz darauf, unseren bestehenden und neuen Kunden Daten und Analysen zu bieten, die zu ihren Zielen passen. Der Bericht kann angepasst werden, um Preistrendanalysen von Zielmarken, Marktverständnis für zusätzliche Länder (fordern Sie die Länderliste an), Daten zu klinischen Studienergebnissen, Literaturübersicht, Analysen des Marktes für aufgearbeitete Produkte und Produktbasis einzuschließen. Marktanalysen von Zielkonkurrenten können von technologiebasierten Analysen bis hin zu Marktportfoliostrategien analysiert werden. Wir können so viele Wettbewerber hinzufügen, wie Sie Daten in dem von Ihnen gewünschten Format und Datenstil benötigen. Unser Analystenteam kann Ihnen auch Daten in groben Excel-Rohdateien und Pivot-Tabellen (Fact Book) bereitstellen oder Sie bei der Erstellung von Präsentationen aus den im Bericht verfügbaren Datensätzen unterstützen.











