



Сегментация глобального рынка классификации веб-данных по компонентам (решения и услуги), методологии (классификация на основе контента, контекстная классификация и классификация на основе пользователей), вертикали (банковское дело, финансовые услуги и страхование (BFSI), здравоохранение и науки о жизни, государственное управление и оборона, образование, телекоммуникации, СМИ и развлечения и другие) — тенденции отрасли и прогноз до 2032 года
Каков размер рынка веб-классификации данных и темпы роста
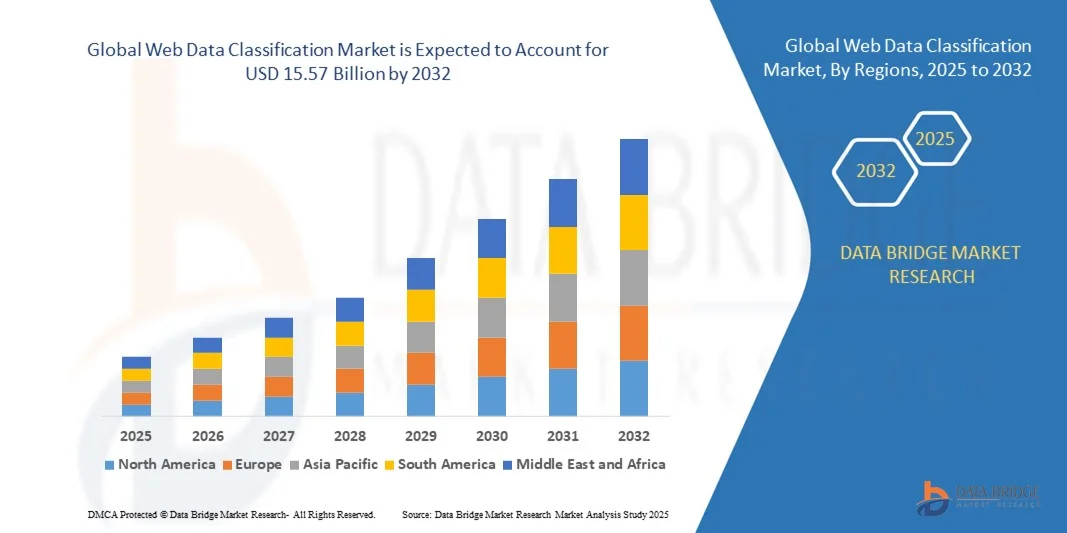
- Размер глобального рынка классификации веб-данных был оценен как$2,58 млрд. в 2024 годуОжидается, что он достигнет15,57 млрд долларов к 2032 году, вCAGR 25,20%в течение прогнозируемого периода
- Рост рынка в значительной степени обусловлен растущим внедрением ИИ, машинного обучения и облачных решений, что позволяет организациям эффективно классифицировать и управлять огромными объемами структурированных и неструктурированных данных в разных отраслях.
- Кроме того, растущий спрос на безопасные, точные и автоматизированные решения для классификации данных побуждает предприятия внедрять передовые платформы, которые обеспечивают соблюдение нормативных требований, конфиденциальность данных и расширенные возможности принятия решений. Эти факторы ускоряют внедрение решений по классификации веб-данных, значительно стимулируя рост рынка.
Каковы основные выводы рынка классификации веб-данных
- Классификация веб-данных включает в себя процесс категоризации данных на основе контента, контекста или поведения пользователя для улучшения.Управление даннымиБезопасность и доступность. Решения используют ИИ, семантический анализ и машинное обучение для оптимизации управления данными, сокращения ручных усилий и повышения операционной эффективности во всех секторах.
- Растущий спрос на классификацию веб-данных в первую очередь обусловлен всплеском генерации цифровых данных, строгими правилами конфиденциальности данных и растущей потребностью организаций в получении действенной информации из неструктурированной информации, тем самым поддерживая обоснованные бизнес-решения и оперативную устойчивость.
- Северная Америка доминирует на рынке классификации веб-данных с долей 33,3%В 2024 году, в связи с ростомоблачный сервиспередовая аналитика и строгие правила конфиденциальности данных, такие как CCPA
- Ожидается, что Азиатско-Тихоокеанский регион станет самым быстрорастущим регионом на рынке классификации веб-данных в течение прогнозируемого периода из-за растущей цифровизации, расширения ИТ и телекоммуникационной инфраструктуры и растущей осведомленности о защите данных в таких странах, как Китай, Япония и Индия.
- Сегмент решений доминировал на рынке с долей рынка 61,8% в 2024 году из-за растущего развертывания передовых инструментов классификации на основе ИИ и машинного обучения, которые помогают организациям эффективно организовывать и управлять огромными объемами неструктурированных и структурированных данных. Решения предлагают автоматизированные, масштабируемые и точные возможности классификации, что позволяет предприятиям улучшать управление данными, соответствие требованиям и аналитику. Предприятия во всех отраслях промышленности отдают приоритет решениям за их способность беспрепятственно интегрироваться с существующими ИТ-инфраструктурами и облачными средами, тем самым снижая ручные усилия и эксплуатационные расходы. Растущий спрос на информацию в режиме реального времени и расширенное принятие решений также способствует принятию комплексных решений.
Размер рынка и прогноз
Глобальная рыночная стоимость (2024) USD
Ожидаемая рыночная стоимость (2032): USD
Прогноз CAGR (2025-2032):
Сфера охвата и сегментация рынка классификации веб-данных
|
Атрибуты |
Классификация веб-данных Ключевые идеи рынка |
|
Сегменты покрыты |
|
|
Страны, охваченные |
Северная Америка
Европа
Азиатско-Тихоокеанский регион
Ближний Восток и Африка
Южная Америка
|
|
Ключевые игроки рынка |
|
|
Рыночные возможности |
|
|
Информационные наборы данных с добавленной стоимостью |
В дополнение к рыночным идеям, таким как рыночная стоимость, темпы роста, сегменты рынка, географический охват, игроки рынка и рыночный сценарий, отчет о рынке, курируемый командой Data Bridge Market Research, включает углубленный экспертный анализ, анализ импорта / экспорта, анализ цен, анализ потребления продукции и анализ пестле. |
Каковы основные тенденции на рынке классификации веб-данных
Растущее использование ИИ для автоматической классификации данных
- Рынок классификации веб-данных быстро расширяется благодаря растущему внедрению технологий искусственного интеллекта (ИИ) для автоматизации процессов категоризации и маркировки данных. Организации, занимающиеся огромным количеством онлайн- и корпоративных веб-данных, используют алгоритмы, основанные на ИИ, для повышения точности, снижения ручной нагрузки и ускорения принятия решений.
- Например, IBM и Microsoft Azure интегрировали системы классификации на основе машинного обучения в свои облачные платформы, обеспечивая автоматизированную маркировку конфиденциальной информации, данных клиентов и проприетарного контента в соответствии с правилами конфиденциальности. Аналогичным образом, AWS Macie использует ИИ для идентификации и классификации персональных данных в облачных средах хранения, обеспечивая повышенную видимость и контроль соответствия.
- Автоматизированные системы классификации, основанные на ИИ, способны обрабатывать большие наборы данных в режиме реального времени, эффективно отличая структурированные, полуструктурированные и неструктурированные данные. Эти решения также адаптируются к развивающимся моделям данных, что позволяет постоянно улучшать точность за счет обучения модели и обучения с подкреплением.
- Кроме того, классификация на основе ИИ повышает операционную эффективность в таких отраслях, как финансы, здравоохранение и розничная торговля, обеспечивая быструю идентификацию критически важных данных для аналитики, аудитов соответствия и протоколов безопасности. Компании выигрывают от снижения человеческих ошибок, оптимизации рабочих процессов и улучшения управления данными.
- Интеграция моделей обработки естественного языка (NLP) и глубокого обучения в инструменты веб-классификации улучшает контекстное понимание, позволяя точно классифицировать сложные наборы данных, такие как отзывы клиентов, юридические документы и мультимедийный контент. Ожидается, что эта тенденция ускорится, поскольку предприятия расширяют инициативы по цифровой трансформации и требуют масштабируемых интеллектуальных решений для управления данными.
- По мере развития возможностей ИИ автоматизированная классификация данных станет краеугольным камнем управления информацией, обеспечивая более быструю и безопасную обработку веб-данных в глобальных отраслях. Эта тенденция подчеркивает растущую зависимость от интеллектуальной автоматизации для крупномасштабного управления цифровыми активами в нормативных и аналитических средах.
Динамика рынка классификации веб-данных
водитель
Повышение нормативного соответствия и потребности в безопасных данных
- Ужесточение глобальных правил конфиденциальности и безопасности данных является основным драйвером рынка классификации веб-данных. Организации должны обеспечить соблюдение таких рамок, как GDPR, CCPA, HIPAA и PCI DSS, которые требуют точной идентификации, маркировки и защиты конфиденциальной информации, хранящейся в Интернете и внутри внутренних систем.
- Например, Forcepoint и Symantec предоставляют решения для классификации, которые помогают компаниям обнаруживать и маркировать конфиденциальные бизнес-данные, личную информацию и платежные реквизиты для выполнения обязательств по соблюдению. Эти инструменты позволяют автоматизировать реализацию политики для безопасной обработки данных при одновременном снижении риска нарушений и нормативных штрафов.
- Растущая распространенность киберугроз и атак вымогателей усилила необходимость точной классификации веб-данных для реализации эффективных мер контроля доступа и шифрования. Выявляя конфиденциальную и ценную информацию на ранних этапах жизненного цикла данных, предприятия могут усилить меры безопасности и улучшить реагирование на инциденты.
- Кроме того, проверки соблюдения все чаще требуют подтверждения мер по управлению данными. Системы классификации веб-данных обеспечивают документированную прослеживаемость и готовую к аудиту отчетность, что облегчает организациям демонстрацию соблюдения правовых и отраслевых стандартов.
- По мере того, как организации сталкиваются с растущими объемами данных и все более тщательным изучением цифровых практик, интеграция инструментов классификации в рабочие процессы предприятий становится важным шагом в обеспечении целостности бизнеса и удовлетворения меняющихся требований соответствия во всем мире.
Сдержанность/вызов
Управление быстрым ростом неструктурированных данных
- Одной из наиболее значительных проблем на рынке классификации веб-данных является управление экспоненциальным ростом неструктурированных данных, таких как электронные письма, мультимедийные файлы, контент в социальных сетях и коммуникации с клиентами. Неструктурированные наборы данных часто не имеют последовательного форматирования, что затрудняет их анализ и классификацию.
- Например, такие компании, как OpenText и Informatica, сталкиваются с постоянными сложностями при классификации крупномасштабных неструктурированных архивов, обеспечивая точность между языками, форматами и постоянно меняющимися структурами контента. Динамический характер текстовых, видео- и графических данных требует передовых аналитических моделей и постоянного совершенствования моделей для эффективной классификации.
- Подавляющий объем неструктурированных веб-данных также может напрягать вычислительные ресурсы, что приводит к увеличению затрат на обработку и увеличению времени классификации. Предприятия часто требуют значительных инвестиций в инфраструктуру ИИ, облачное хранилище и масштабируемые вычислительные мощности для эффективного управления такими рабочими нагрузками.
- Кроме того, неточная классификация неструктурированных данных может привести к неправильному управлению конфиденциальной информацией, создавая риски соответствия и подрывая протоколы безопасности. Обеспечение точности маркировки требует высококачественных обучающих наборов данных, которые могут быть дорогостоящими и трудоемкими для разработки.
- Хотя достижения в области ИИ, НЛП и глубокого обучения улучшают возможности, непредсказуемый характер и огромное разнообразие неструктурированных данных остаются постоянными барьерами. Преодоление этих проблем потребует инноваций в адаптивных моделях классификации, гибридных структурах управления данными и инструментах обработки в режиме реального времени для поддержания точности при обработке быстро растущих объемов данных.
Как сегментируется рынок классификации веб-данных
Рынок сегментирован на основе компонентов, методологии и вертикали.
- Компонент
На основе компонента рынок классификации веб-данных сегментирован на решения и услуги. Сегмент решений доминировал на рынке с наибольшей долей выручки в 61,8% в 2024 году, что обусловлено растущим внедрением передовых инструментов классификации на основе ИИ и машинного обучения, которые помогают организациям эффективно организовывать и управлять огромными объемами неструктурированных и структурированных данных. Решения предлагают автоматизированные, масштабируемые и точные возможности классификации, что позволяет предприятиям улучшать управление данными, соответствие требованиям и аналитику. Предприятия во всех отраслях промышленности отдают приоритет решениям за их способность беспрепятственно интегрироваться с существующими ИТ-инфраструктурами и облачными средами, тем самым снижая ручные усилия и эксплуатационные расходы. Растущий спрос на информацию в режиме реального времени и расширенное принятие решений также способствует принятию комплексных решений.
Ожидается, что в сегменте услуг будут наблюдаться самые быстрые темпы роста с 2025 по 2032 год, чему способствует растущая зависимость от профессионального консалтинга, внедрения и управляемых услуг для проектов классификации данных. Услуги предоставляют индивидуальные решения, адаптированные к конкретной среде данных организации, обеспечивая более высокую точность и соответствие отраслевым стандартам. Компании, не имеющие собственного опыта, предпочитают услуги по развертыванию, мониторингу и постоянной оптимизации структур классификации. Кроме того, управляемые услуги и предложения на основе подписки делают экономически эффективным для малых и средних предприятий внедрение передовых возможностей классификации.
- По методологии
На основе методологии рынок классификации веб-данных подразделяется на классификацию на основе контента, классификацию на основе контекста и классификацию на основе пользователей. Сегмент классификации контента занимал самую большую долю рынка в 2024 году, что обусловлено его способностью анализировать внутренние свойства данных, включая ключевые слова, метаданные и структуры документов, точно классифицировать и отмечать контент. Эта методология широко используется предприятиями, которые ищут автоматизированные, масштабируемые решения для классификации, которые минимизируют вмешательство человека при обеспечении соответствия нормативным стандартам. Его эффективность в больших наборах данных в BFSI, здравоохранении и государственном секторе лежит в основе его доминирующего положения на рынке.
Ожидается, что сегмент классификации на основе контекста станет самым быстрым CAGR с 2025 по 2032 год, чему будет способствовать растущий спрос на интеллектуальные системы классификации, которые учитывают окружающий контекст, отношения и смысл данных. Контекстные подходы позволяют организациям получить более глубокое понимание, улучшить персонализацию и более эффективно выявлять аномалии. Предприятия, обрабатывающие сложные наборы данных, такие как финансовые операции или записи пациентов, все чаще используют контекстные методологии для повышения точности, уменьшения ошибок и оптимизации рабочих процессов.
- Вертикальный
На основе вертикали рынок классификации веб-данных сегментирован на BFSI, здравоохранение и науки о жизни, правительство и оборону, образование, телекоммуникации, СМИ и развлечения и другие. Вертикаль BFSI доминировала на крупнейшей доле рынка в 2024 году, что обусловлено критической потребностью в безопасной, совместимой и эффективной обработке конфиденциальных финансовых данных. Банки, страховые компании и инвестиционные фирмы все чаще используют автоматизированные системы классификации для оптимизации оценки рисков, соблюдения нормативных требований, выявления мошенничества и аналитики клиентов. Большой объем транзакционных и клиентских данных еще больше усиливает спрос на передовые решения в этом секторе.
Ожидается, что вертикаль здравоохранения и наук о жизни будет наблюдать самые быстрые темпы роста с 2025 по 2032 год, чему способствует растущая оцифровка медицинских записей, данных исследований и информации о клинических испытаниях. Организации здравоохранения принимают классификацию веб-данных для улучшения управления данными пациентов, ускорения исследований и обеспечения соблюдения правил, таких как HIPAA и GDPR. Расширенные методологии классификации помогают в организации неструктурированных медицинских записей, облегчая понимание в реальном времени, прогнозную аналитику и персонализированный уход за пациентами. Растущее внедрение технологий искусственного интеллекта и машинного обучения в больницах, лабораториях и фармацевтических компаниях еще больше ускоряет рост этой вертикали.
В каком регионе находится наибольшая доля рынка классификации веб-данных
- Северная Америка доминировала на рынке классификации веб-данных с самой большой долей дохода 33,3% в 2024 году, чему способствовало растущее внедрение облачных вычислений, расширенной аналитики и строгих правил конфиденциальности данных, таких как CCPA.
- Предприятия в регионе уделяют приоритетное внимание управлению данными и их соблюдению для решения растущих проблем, связанных с киберугрозами и неправильным использованием информации.
- Наличие крупных поставщиков технологий, раннее внедрение инструментов классификации данных на основе ИИ и высокие инвестиции в инфраструктуру безопасности данных еще больше укрепляют региональное доминирование.
Американский анализ рынка веб-данных
Американский рынок классификации веб-данных получил самую большую долю доходов в 2024 году в Северной Америке, чему способствовала быстрая реализация инициатив цифровой трансформации и повышение внимания к соблюдению нормативных требований. Всплеск неструктурированной генерации данных в сочетании с расширением облачных развертываний на предприятиях стимулирует рост рынка. Кроме того, присутствие крупных технологических компаний и растущее внедрение в BFSI, здравоохранении и государственном секторе продолжают стимулировать расширение рынка.
Европейская классификация веб-данных Market Insight
Ожидается, что европейский рынок классификации веб-данных будет расширяться на значительном CAGR в течение прогнозируемого периода, в первую очередь за счет строгих правил защиты данных, таких как GDPR, и растущего внимания к защите корпоративных данных. Растущая цифровизация в различных отраслях промышленности и растущее внедрение автоматизированных решений для управления данными способствуют внедрению. Европейские организации делают упор на системы классификации с поддержкой ИИ для оптимизации соблюдения, повышения прозрачности и снижения рисков утечки данных.
Великобритания Web Data Classification Market Insight
Ожидается, что в течение прогнозируемого периода рынок классификации веб-данных в Великобритании будет расти с заметным CAGR, что обусловлено ужесточением законов о конфиденциальности данных и расширением использования цифровых технологий в финансовом, государственном и медицинском секторах. Растущие инвестиции региона в инфраструктуру данных в сочетании с растущим спросом на автоматизированные инструменты обработки данных и соблюдения нормативных требований способствуют росту рынка.
Немецкий рынок классификации веб-данных
Ожидается, что в течение прогнозируемого периода рынок классификации веб-данных в Германии будет расширяться на значительном CAGR, чему будет способствовать акцент страны на кибербезопасности, соблюдении нормативных требований и промышленной оцифровке. Предприятия в производственном и государственном секторах внедряют платформы классификации на основе ИИ для эффективного управления большими объемами данных. Сильное внимание Германии к суверенитету данных и инновационной ИТ-политике продолжает поддерживать устойчивое расширение рынка.
Азиатско-Тихоокеанский рынок классификации веб-данных
Рынок классификации веб-данных в Азиатско-Тихоокеанском регионе будет расти самыми быстрыми темпами с 2025 по 2032 год, что обусловлено растущей цифровизацией, расширением ИТ и телекоммуникационной инфраструктуры и растущей осведомленностью о защите данных в таких странах, как Китай, Япония и Индия. Быстрый рост электронной коммерции и облачных услуг, наряду с правительственными инициативами, способствующими цифровому управлению, ускоряет внедрение. Ожидается, что большой объем данных в регионе и новые возможности ИИ будут поддерживать устойчивый импульс роста.
Китайский рынок классификации веб-данных
Китайский рынок классификации веб-данных составил самую большую долю доходов рынка в Азиатско-Тихоокеанском регионе в 2024 году, что объясняется сильными правительственными мандатами по безопасности данных и быстрым внедрением в электронной коммерции, финансах и государственном секторе. Акцент Китая на построении безопасных цифровых экосистем при поддержке отечественных поставщиков ИИ и облачных технологий продолжает стимулировать рост рынка.
Японский рынок классификации веб-данных
Японский рынок классификации веб-данных набирает обороты благодаря технологическому прогрессу страны, высоким стандартам соответствия нормативным требованиям и растущему внедрению ИИ и аналитики больших данных. Рост инициатив цифровой трансформации в здравоохранении, BFSI и государственном секторе в сочетании со спросом на безопасное и эффективное управление данными способствует устойчивому росту рынка.
Какие компании являются ведущими на рынке классификации веб-данных
Отрасль классификации веб-данных в основном возглавляется хорошо зарекомендовавшими себя компаниями, в том числе:
- IBM Corporation(США)
- Google(США)
- Microsoft(США)
- Amazon Web Services, Inc.(США)
- Бродком(США)
- Open Text Corporation (Канада)
- Болдон Джеймс (Великобритания)
- Варонис (США)
- Innovative Routines International (IRI), Inc.
- MinerEye (Израиль)
- PKWARE, Inc. (США)
- Informatica Corporation (США)
- Spirion, LLC (США)
- Clearswift GmbH (Германия)
- SECLORE (Индия)
- Титус (Канада)
- Netwrix Corporation (США)
- GTB Technologies, Inc. (США)
- Forcepoint (США)
- ConnectWise, LLC (США)
- SoftWorks AI (США)
- Janusnet Pty Limited (Австралия)
Каковы последние тенденции на мировом рынке классификации веб-данных
- В октябре 2025 года Clarivate запустила свой Innography AI Classifier, предлагая возможности классификации патентов с точностью до 97%. Этот прогресс подчеркивает растущую зависимость от систем классификации, основанных на ИИ, для автоматизации крупномасштабной категоризации данных и повышения точности принятия решений на предприятии. Снижая ручное вмешательство и повышая эффективность бенчмаркинга, это нововведение усиливает интеграцию интеллектуальной классификации данных в стратегические бизнес-операции.
- В сентябре 2025 года Squirro, мировой лидер в области генеративного ИИ корпоративного уровня и решений для графов знаний, объявил об общей доступности своего последнего обновления платформы, представив классификатор Squirro. Обновление улучшает управление корпоративными данными с помощью автоматизированной классификации, согласованной с организационными таксономиями, расширенным обнаружением PII и маскированием для соблюдения конфиденциальности. Эти обновления значительно повышают точность данных, безопасность и контекстный интеллект, позволяя организациям разблокировать более глубокие выводы из неструктурированных данных.
- В июне 2025 года Zscaler представила новые функции классификации данных на основе ИИ, предназначенные для идентификации и классификации более 200 чувствительных типов данных с человеческой точностью. Этот прогресс подчеркивает ускоренную интеграцию искусственного интеллекта в рамки безопасности данных, повышение эффективности контекстного анализа и классификации в режиме реального времени. Расширение функции знаменует собой важный шаг к тому, чтобы предприятия могли безопасно и разумно обрабатывать огромные объемы конфиденциальной информации.
- В июне 2025 года Progress выпустила расширенное обновление своей платформы Semaphore, включающее возможности семантического ИИ, которые автоматизируют извлечение и классификацию структурированных и неструктурированных данных. Этот выпуск демонстрирует постоянное сближение между управлением знаниями и управлением данными, предоставляя предприятиям возможность более эффективно управлять, интерпретировать и защищать активы данных. Интеграция семантического интеллекта способствует улучшению соответствия, операционной прозрачности и генерации идей.
- В августе 2024 года компания Varonis представила решение Data Discovery and Classification на базе искусственного интеллекта, повысив способность предприятий обнаруживать, отслеживать и классифицировать конфиденциальную информацию в различных средах хранения. Эта разработка отражает растущий спрос на интеллектуальную автоматизацию при идентификации данных высокого риска и обеспечении соблюдения протоколов защиты. Укрепляя видимость и контроль над корпоративными данными, решение способствует улучшению соответствия нормативным требованиям и безопасности во всех отраслях.
SKU-
Получите онлайн-доступ к отчету на первой в мире облачной платформе рыночной аналитики

- Интерактивная панель анализа данных
- Панель анализа компании для возможностей с высоким потенциалом роста
- Доступ аналитика-исследователя для настройки и запросов
- Анализ конкурентов с помощью интерактивной панели
- Последние новости, обновления и анализ тенденций
- Используйте возможности сравнительного анализа для комплексного отслеживания конкурентов
Методология исследования
Сбор данных и анализ базового года выполняются с использованием модулей сбора данных с большими размерами выборки. Этап включает получение рыночной информации или связанных данных из различных источников и стратегий. Он включает изучение и планирование всех данных, полученных из прошлого заранее. Он также охватывает изучение несоответствий информации, наблюдаемых в различных источниках информации. Рыночные данные анализируются и оцениваются с использованием статистических и последовательных моделей рынка. Кроме того, анализ доли рынка и анализ ключевых тенденций являются основными факторами успеха в отчете о рынке. Чтобы узнать больше, пожалуйста, запросите звонок аналитика или оставьте свой запрос.
Ключевой методологией исследования, используемой исследовательской группой DBMR, является триангуляция данных, которая включает в себя интеллектуальный анализ данных, анализ влияния переменных данных на рынок и первичную (отраслевую экспертную) проверку. Модели данных включают сетку позиционирования поставщиков, анализ временной линии рынка, обзор рынка и руководство, сетку позиционирования компании, патентный анализ, анализ цен, анализ доли рынка компании, стандарты измерения, глобальный и региональный анализ и анализ доли поставщика. Чтобы узнать больше о методологии исследования, отправьте запрос, чтобы поговорить с нашими отраслевыми экспертами.
Доступна настройка
Data Bridge Market Research является лидером в области передовых формативных исследований. Мы гордимся тем, что предоставляем нашим существующим и новым клиентам данные и анализ, которые соответствуют и подходят их целям. Отчет можно настроить, включив в него анализ ценовых тенденций целевых брендов, понимание рынка для дополнительных стран (запросите список стран), данные о результатах клинических испытаний, обзор литературы, обновленный анализ рынка и продуктовой базы. Анализ рынка целевых конкурентов можно проанализировать от анализа на основе технологий до стратегий портфеля рынка. Мы можем добавить столько конкурентов, о которых вам нужны данные в нужном вам формате и стиле данных. Наша команда аналитиков также может предоставить вам данные в сырых файлах Excel, сводных таблицах (книга фактов) или помочь вам в создании презентаций из наборов данных, доступных в отчете.











